Rodrigo Viana
Especialista de Garantia de Qualidade (QA Associate Specialist) na Axians Low-Code, com mais de 15 anos de experiência em testes de software em projetos do setor público, instituições financeiras e empresas privadas. É certificado pela ISTQB® nas áreas de automação de testes (CTAL-TAE) e testes de segurança (CTAL-ST), além de Foundation Level (CTFL).
Ao longo da carreira especializou-se em automação funcional (Selenium, Appium, Playwright, Katalon, UiPath), testes de performance e TestOps, com forte experiência no ecossistema OutSystems. Mais recentemente tem-se dedicado à aplicação de IA generativa aos testes, incluindo a geração de massa de dados, execução autónoma e avaliação de respostas.
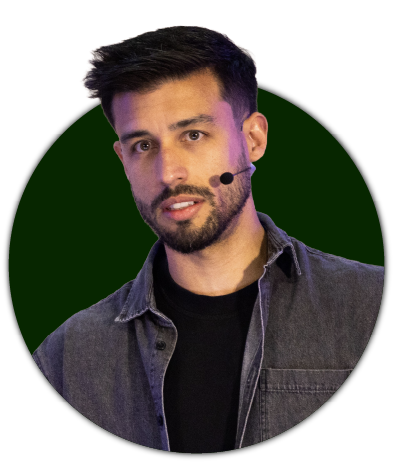
Rodrigo Viana
Especialista de Garantia de Qualidade (QA Associate Specialist) na Axians Low-Code, com mais de 15 anos de experiência em testes de software em projetos do setor público, instituições financeiras e empresas privadas. É certificado pela ISTQB® nas áreas de automação de testes (CTAL-TAE) e testes de segurança (CTAL-ST), além de Foundation Level (CTFL).
Ao longo da carreira especializou-se em automação funcional (Selenium, Appium, Playwright, Katalon, UiPath), testes de performance e TestOps, com forte experiência no ecossistema OutSystems. Mais recentemente tem-se dedicado à aplicação de IA generativa aos testes, incluindo a geração de massa de dados, execução autónoma e avaliação de respostas.
CALENDÁRIO
Call for Speakers
27 Outubro
Quando o "AI as a Judge" Não Basta: Testar a Qualidade de um Chatbot com LLM, do Funcional ao Red Team
Os chatbots baseados em LLM estão a multiplicar-se, mas testá-los levanta um desafio novo: as respostas não são determinísticas e os métodos tradicionais de QA não chegam. Nesta apresentação será partilhado um caso real da Axians para o IPDJ (Instituto Português do Desporto e Juventude): garantir a qualidade do Appy, o chatbot do Apptiva, que responde com recurso a um LLM.
Começámos por adaptar a ferramenta DeepEval, que usa a abordagem “AI as a Judge”. Rapidamente percebemos que os seus resultados — uma simples contagem de casos aprovados e reprovados face a um intervalo predefinido — não eram suficientes para garantir qualidade. Por isso construímos uma camada de testes própria, organizada em várias dimensões: testes funcionais, em que gerámos massa de dados com IA para validar se o chatbot respondia de forma coerente às FAQ e às suas variações naturais; testes de segurança, para garantir que informação interna e dos utilizadores não era exposta e que não eram dadas recomendações de saúde ou medicação; e testes de red team, focados em prompt injection e code injection.
Para tornar os resultados acionáveis, usámos IA generativa para criar um relatório visual que permite comparar o histórico de execuções e analisar regressões e melhorias a cada mudança de modelo, de prompt base ou dos textos das FAQ.
Termino com a ideia que considero central: o QA precisa de dominar conceitos técnicos como “AI as a Judge” e combiná-los com o seu conhecimento de qualidade para testar com sucesso a nova geração de aplicações com LLM.
Calendário
Call for Speakers
27 Outubro
Quando o "AI as a Judge"
Não Basta: Testar a Qualidade de um Chatbot com LLM,
do Funcional ao Red Team
Os chatbots baseados em LLM estão a multiplicar-se, mas testá-los levanta um desafio novo: as respostas não são determinísticas e os métodos tradicionais de QA não chegam. Nesta apresentação será partilhado um caso real da Axians para o IPDJ (Instituto Português do Desporto e Juventude): garantir a qualidade do Appy, o chatbot do Apptiva, que responde com recurso a um LLM.
Começámos por adaptar a ferramenta DeepEval, que usa a abordagem “AI as a Judge”. Rapidamente percebemos que os seus resultados — uma simples contagem de casos aprovados e reprovados face a um intervalo predefinido — não eram suficientes para garantir qualidade. Por isso construímos uma camada de testes própria, organizada em várias dimensões: testes funcionais, em que gerámos massa de dados com IA para validar se o chatbot respondia de forma coerente às FAQ e às suas variações naturais; testes de segurança, para garantir que informação interna e dos utilizadores não era exposta e que não eram dadas recomendações de saúde ou medicação; e testes de red team, focados em prompt injection e code injection.
Para tornar os resultados acionáveis, usámos IA generativa para criar um relatório visual que permite comparar o histórico de execuções e analisar regressões e melhorias a cada mudança de modelo, de prompt base ou dos textos das FAQ.
Termino com a ideia que considero central: o QA precisa de dominar conceitos técnicos como “AI as a Judge” e combiná-los com o seu conhecimento de qualidade para testar com sucesso a nova geração de aplicações com LLM.